Cloudflare security-audit-skill: AI agent tự audit bảo mật
 Quản trị viên
Cloudflare mở source skill biến coding agent thành kiểm toán viên bảo mật: 6 giai đoạn, xác minh chéo, sandbox bắt buộc. Cách cài và dùng thực tế.
Đa số dự án AI trên GitHub đang cố làm agent viết code nhanh hơn. Một repo của Cloudflare đi ngược lại: dạy agent đọc code để tìm lỗ hổng, rồi tự kiểm chứng lại chính phát hiện của mình trước khi báo cáo. Đó là cloudflare/security-audit-skill — tính đến 18/11/2026 đã có 74.810 sao và 5.007 bản fork, giấy phép MIT.
Điểm đáng chú ý: đây không phải sản phẩm đóng gói. Nó là bộ skill (kỹ năng) mà bạn cắm vào coding agent đang dùng — Claude Code, Codex, hay bất kỳ agent nào có tool use và gọi được sub-agent song song. Agent của bạn vẫn là agent của bạn, chỉ là giờ nó biết cách hành xử như một kiểm toán viên bảo mật thay vì một máy sinh code.
Vì sao một skill lại được săn đón đến vậy
Repo này là hạt giống của bộ khung tìm lỗ hổng mà Cloudflare dùng nội bộ, kể lại trong bài Build your own vulnerability harness. Ý tưởng cốt lõi rất tỉnh: mô hình AI không đáng tin khi tự chấm điểm mình. Nếu cùng một agent vừa tìm lỗi vừa xác nhận lỗi, nó sẽ luôn thấy mình đúng.
Cách Cloudflare giải quyết: tách vai. Agent tìm lỗi và agent kiểm chứng là hai thực thể khác nhau, dùng ngữ cảnh khác nhau. Agent kiểm chứng được giao nhiệm vụ tìm cách bác bỏ phát hiện kia, chứ không phải xác nhận nó. Chi tiết này nghe nhỏ nhưng nó là toàn bộ khác biệt giữa một danh sách lỗi có thể hành động và một danh sách 200 dòng nhiễu khiến đội dev bỏ luôn báo cáo.
Sáu giai đoạn của một lần audit
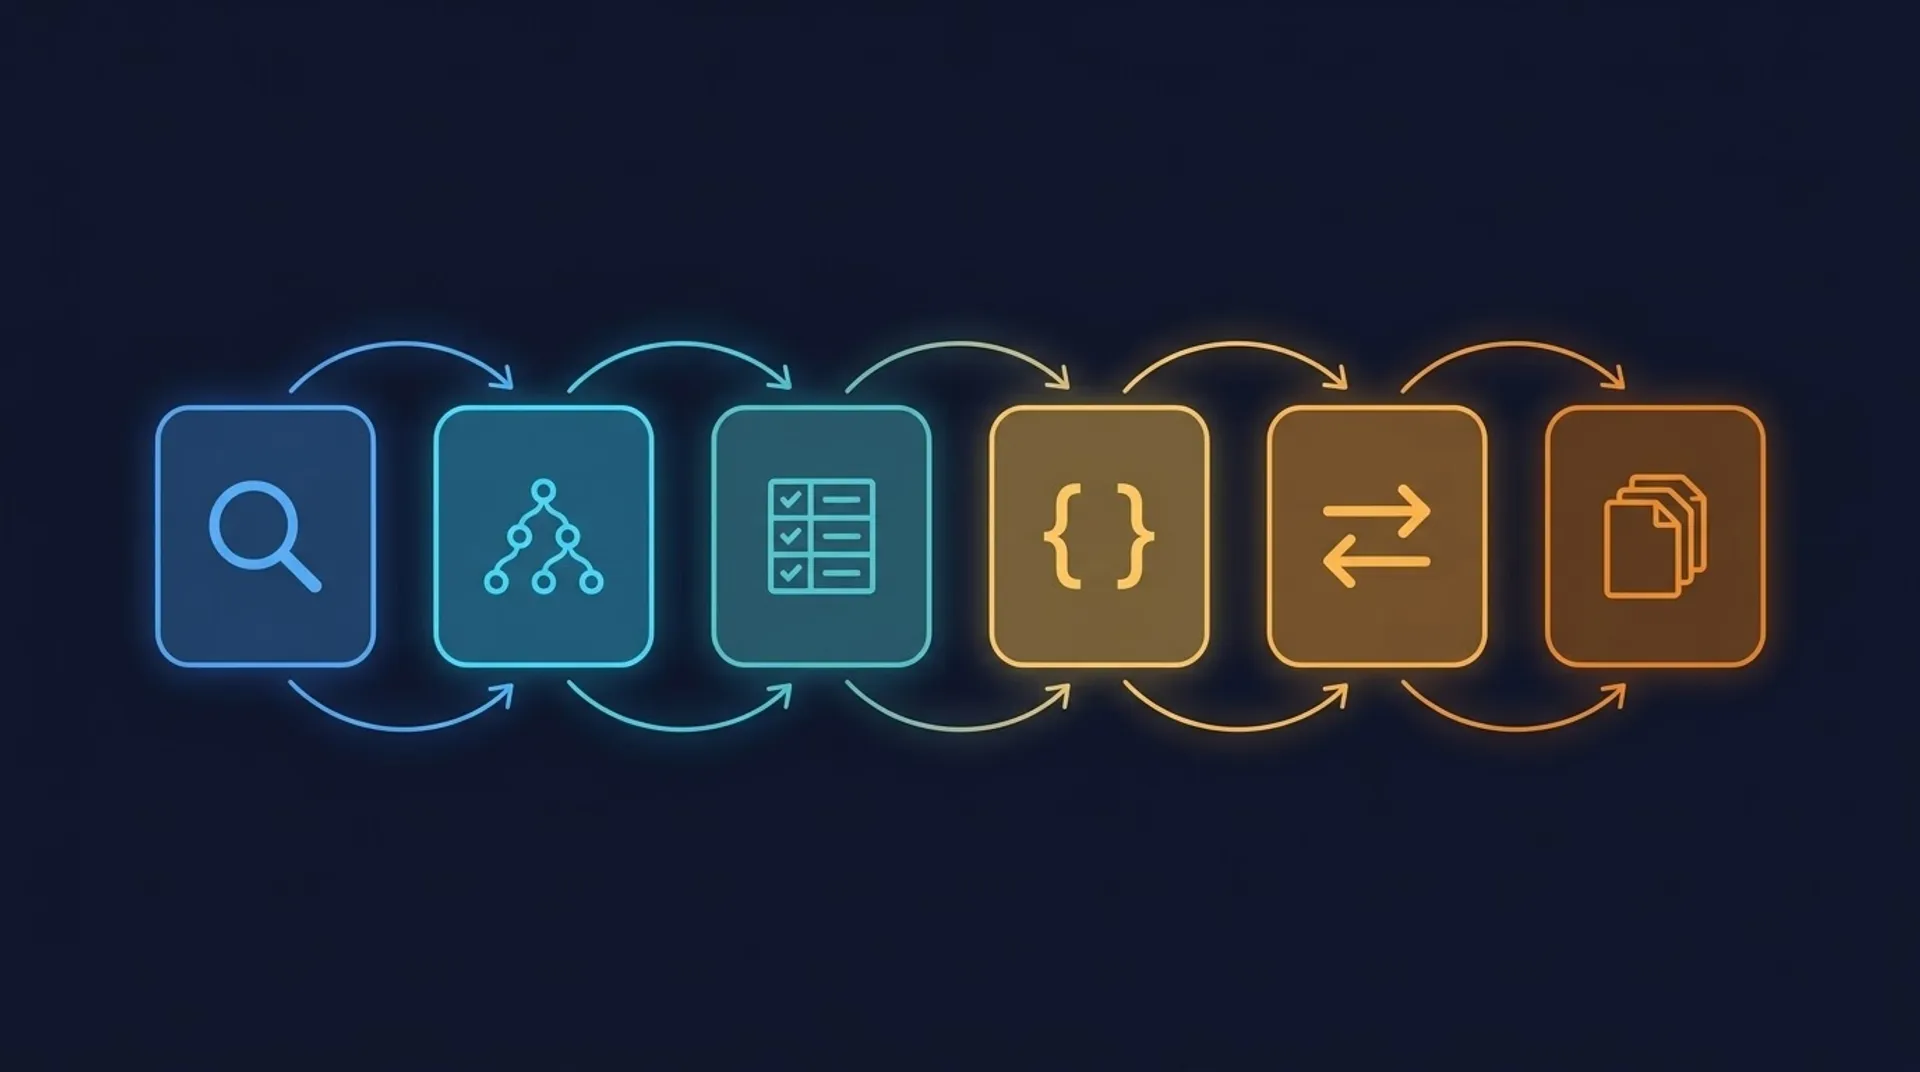
Quy trình không phải "quét xong in kết quả". Nó có trạng thái, có sổ theo dõi độ phủ, và mỗi giai đoạn có đầu ra riêng:
- Trinh sát — vẽ kiến trúc, ranh giới tin cậy, bề mặt nhận dữ liệu vào, và dựng sổ độ phủ
coverage-ledger.json. Chưa tìm lỗi gì ở bước này. - Đi săn theo độ phủ — chia việc từ sổ thành từng đơn vị, giao cho các hunter độc lập, rồi dùng "coverage critic" soi xem còn vùng nào chưa ai chạm.
- Kiểm chứng ứng viên — mỗi phát hiện duy nhất được giao cho một verifier mới, nhiệm vụ là bác bỏ nó.
- Kết xuất có cấu trúc — ghi ra
findings.jsontheo đúng ba trạng thái, đối chiếu vớireport-schema.jsonvà chạy validator. - Xác minh bản ghi độc lập — agent mới kiểm lại các khẳng định nguồn lần cuối; nếu có thay thế thì phải qua thêm một verifier nữa.
- Báo cáo trung lập — sinh
REPORT.md,FINDINGS-DETAIL.md,NEEDS-VALIDATION.mdtừ các bản ghi đã xác minh, không phải từ lời kể của agent.
Ba trạng thái, và vì sao "chưa xác minh" không phải lỗi
Đây là phần tôi thấy đáng học nhất, kể cả khi bạn không dùng repo này. Kết quả audit chỉ có ba nhãn:
- confirmed — có đường dẫn nguồn đầy đủ và kết quả quan sát được trong giới hạn. Chỉ nhãn này mới được gán mức độ nghiêm trọng.
- needs_validation — giả thuyết có cơ sở từ source nhưng thiếu đúng một dữ kiện chưa xác định. Không gán severity.
- rejected — ứng viên đã bị bác bỏ, ghi lại để lần sau không ai đào lại.
Điểm dễ hiểu sai: needs_validation không phải "lỗi nhẹ". Nó là "tôi biết chỗ này đáng ngờ nhưng chưa chứng minh được". Trộn hai thứ này là cách nhanh nhất để báo cáo bảo mật mất uy tín.
Repo còn đặt ra một nguyên tắc khó chịu nhưng đúng: thiếu một lớp phòng thủ không phải là lỗ hổng. Nếu lớp A đã chặn được đòn tấn công thì việc thiếu lớp B chỉ là ghi chú gia cố, không phải phát hiện. Nghe hiển nhiên, nhưng đây chính là loại rác chiếm phần lớn báo cáo bảo mật do AI sinh ra hiện nay.
Điều kiện chạy: sandbox không phải tùy chọn
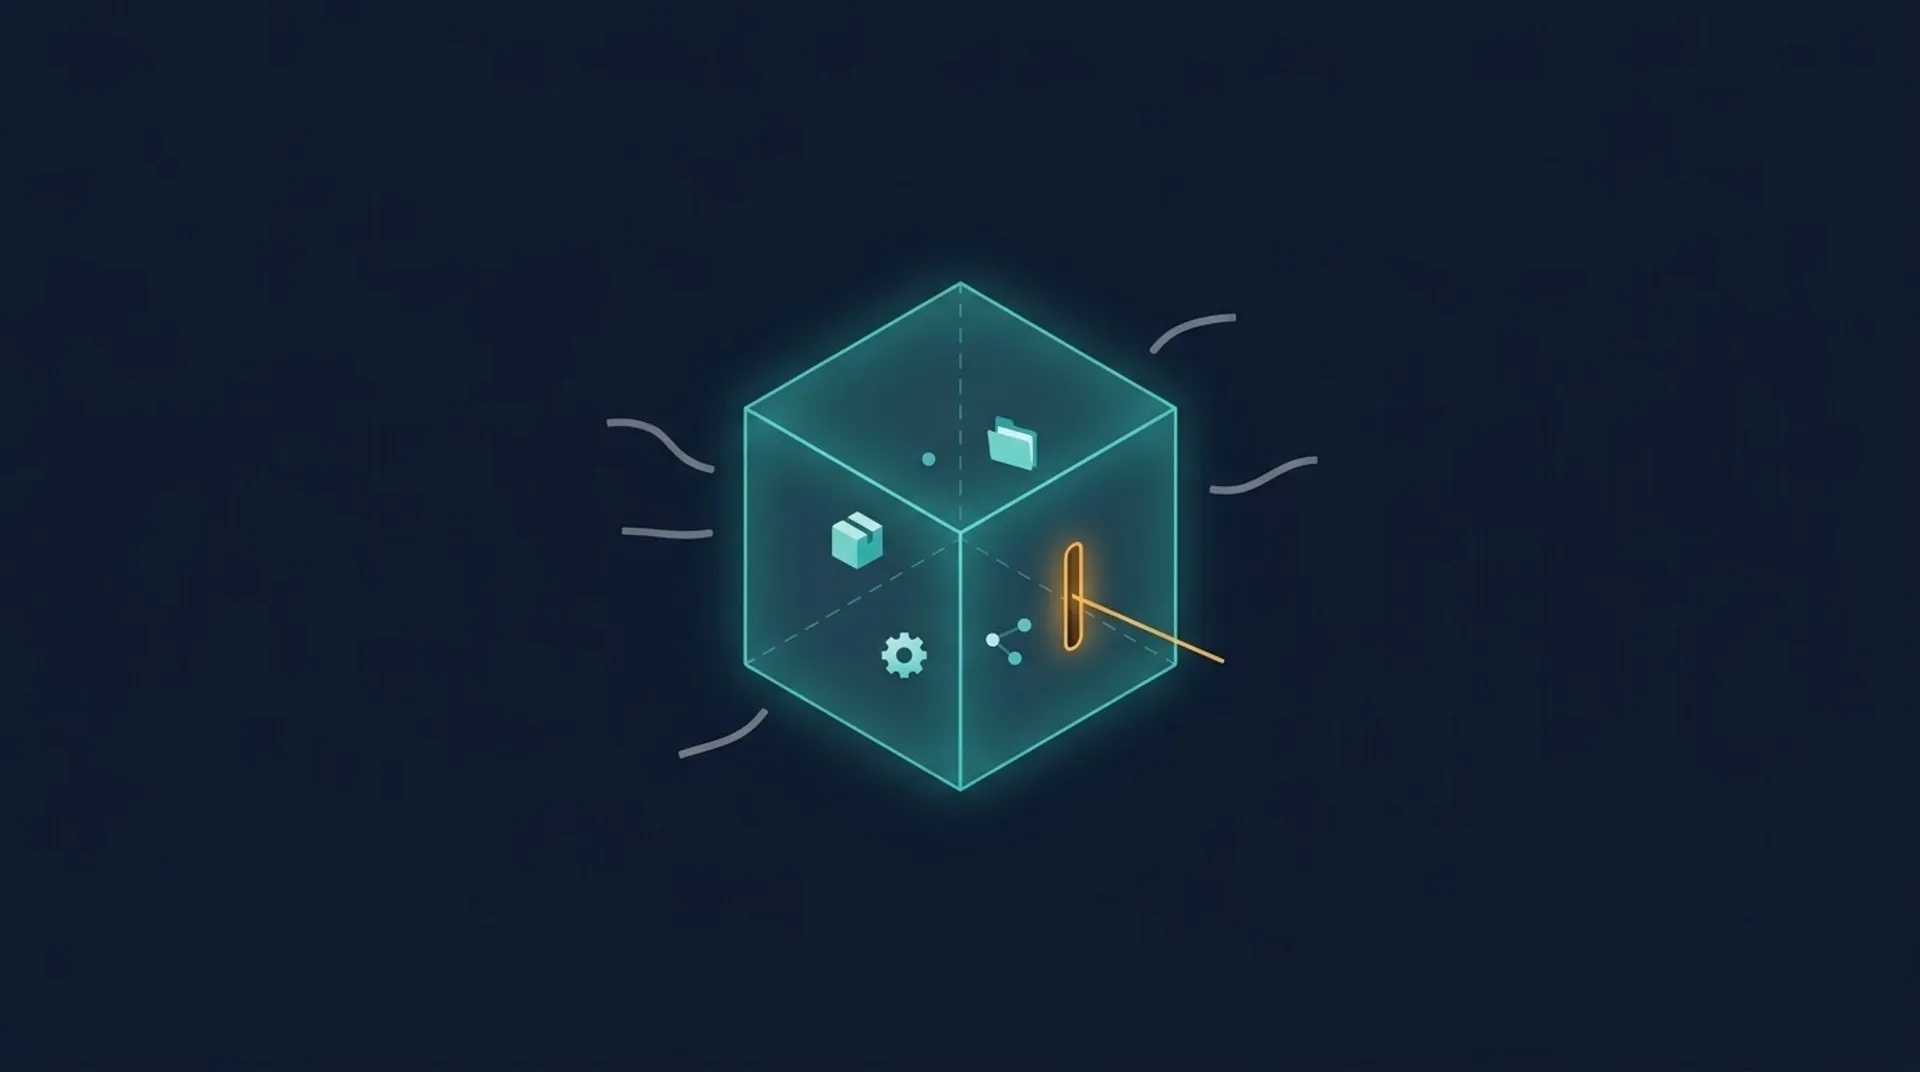
Phần này hay bị bỏ qua khi đọc README, và nó là lý do nhiều người cài xong thấy skill "không làm gì cả". Muốn agent chạy thử mã của target — build, test, mở browser, chạy fuzzer — thì phải có sandbox do hệ điều hành cưỡng chế, đủ bốn điều:
- Không có mạng ra ngoài, chỉ loopback cô lập khi cần client/server nội bộ.
- Môi trường rỗng, chỉ nạp từ allowlist;
HOME, thư mục tạm và cache đều trỏ vào scratch cục bộ. - Target và toolchain chỉ đọc; tiến trình của target chỉ ghi được trong
scratch/được cấp. - Giới hạn rõ ràng về CPU, RAM, số tiến trình, kích thước file và thời gian chạy.
Nếu thiếu bất kỳ điều nào, skill không chạy mã của target. Nó giữ phát hiện ở trạng thái needs_validation kèm đúng dữ kiện còn thiếu. Đây là thiết kế có chủ ý: thà báo "chưa xác minh được" còn hơn chạy mã lạ trên máy bạn rồi báo sai.
Cài đặt và dùng
Cần một coding agent có tool use và gọi được sub-agent song song, cộng Node.js cho hai validator. Cài bằng Skills CLI:
npx skills add https://github.com/cloudflare/security-audit-skill \
  --skill security-audit
Dùng toàn cục thì thêm --global. Sau đó mở agent ngay trong thư mục repo cần kiểm và nói bằng tiếng người:
security audit this codebase
find security vulnerabilities in ./src
do a security review, output to ~/audits/my-project
Skill tự kích hoạt khi câu lệnh khớp trigger. Mặc định nó ở guidance mode — chỉ trả lời câu hỏi bảo mật, không tự tạo thư mục và không chạy đủ sáu giai đoạn. Muốn chạy đầy đủ thì phải nói rõ "audit toàn bộ", "review end-to-end", hoặc yêu cầu xuất file báo cáo. Đây là chi tiết thiết kế tốt: nạp skill không đồng nghĩa với được phép ghi file.
Ba mức chạy và ngân sách
Repo định nghĩa ba profile để bạn không đốt tiền vào một repo 20 file:
- quick — một đợt hunter duy nhất, một lượt critic, một verifier cho mỗi ứng viên. Hợp với repo nhỏ hoặc chạy lại sau khi sửa.
- standard — mặc định. Nhiều đợt hunter, critic sau mỗi đợt, cộng một critic dọn sạch cuối cùng.
- deep — chia đơn vị theo subsystem và vòng đời, chạy critic đến khi sạch, xác minh và xác minh lại bằng agent riêng.
Điều thực dụng: bạn đặt được ngân sách bằng số lần gọi agent. Repo có hẳn một cổng kiểm tra trước khi tiêu: nó giữ chỗ cho critic và verifier trước, chỉ giao hunter khi còn đủ tiền cho phần kiểm chứng. Nếu ngân sách không đủ nuôi tối thiểu, nó không chạy gì cả và báo lý do, thay vì chạy nửa vời rồi báo cáo như đã xong. Với ai từng trả tiền API cho một lượt audit "xong" mà thực chất chỉ quét được 30% code, chi tiết này đáng giá.
Hiệu quả thật: một lần chạy không đủ
Cloudflare nói thẳng trong README: trong các lần thử của họ, một lần chạy chỉ tìm được khoảng một nửa số lỗ hổng mà nhiều lần chạy cộng lại tìm ra. Vì vậy repo thiết kế để các lần chạy cộng dồn: đọc sổ phủ và findings cũ, nhắm vào vùng còn trống, kiểm lại phần source đã đổi, không coi việc cũ là đã phủ.
Hệ quả thực tế: đừng dùng repo này như một lần quét lấy yên tâm. Nó là công cụ để chạy định kỳ và cộng dồn độ phủ. Và đừng bao giờ đọc "lần này không tìm thấy gì" thành "code không có lỗi".
Nên và không nên dùng
Nên khi bạn có codebase thật, có ranh giới tin cậy rõ (API, CLI, daemon, service), và có môi trường cô lập để chạy thử. Cũng nên đọc phần ATTACK-CLASSES.md và các file chuyên đề — danh mục tấn công ở đó hữu ích như checklist tư duy, kể cả khi bạn tự review bằng tay.
Không nên khi bạn cần kết quả trong 10 phút, khi chỉ có một file script nhỏ, hoặc khi định đem nó quét thẳng lên hệ thống production đang chạy. Repo nói rõ: không thử trên endpoint đã deploy, không thử dịch vụ dùng chung, không tiêu quota API trả tiền. Muốn chắc chắn thì phải dựng fixture và principal giả.
Và một giới hạn cần nói thẳng: skill này không thay được người. Nó lọc hàng nghìn ứng viên xuống một hàng đợi đáng đọc, nhưng quyết định cuối cùng vẫn là của người đọc báo cáo. Giá trị lớn nhất của nó không phải "tìm ra lỗi", mà là cơ chế chống tự lừa mình: tách người tìm khỏi người xác nhận, bắt buộc có bằng chứng nguồn, và cho phép nói "chưa biết".
Kết luận
Trong một năm mà gần như mọi repo AI mới đều là "agent làm được nhiều việc hơn", cloudflare/security-audit-skill chọn hướng khó hơn: dạy agent biết nghi ngờ chính mình. 74.810 sao trong khoảng 5 tháng cho thấy đây là vấn đề đội dev thật sự đau — không phải thiếu công cụ tìm lỗi, mà thiếu công cụ lọc bớt lỗi giả.
Nếu bạn đang dùng Claude Code hay Codex cho công việc hằng ngày, đây là một trong số ít skill đáng cài thử: nó không thêm khả năng mới cho agent, nó sửa cách agent kết luận. Mà trong bảo mật, cách kết luận quan trọng hơn tốc độ quét.
Repo: github.com/cloudflare/security-audit-skill — MIT, 22 file, không phụ thuộc runtime nặng.