Indra OCR: đọc PDF và ảnh scan trên CPU, không cần GPU
 Quản trị viên
Indra OCR của Datalab: 1 triệu tham số, chạy CPU, đọc 80+ ngôn ngữ. Tôi tự cài và đo tiếng Việt thật: 97,4% từ đúng, nhưng lỗi dấu có hệ thống.
Có một nghịch lý trong các dự án AI năm nay: mọi thứ đều đòi GPU. Nhưng công việc nhàm chán nhất — đọc một đống PDF scan thành chữ — lại không cần GPU chút nào. Indra OCR của Datalab đi đúng vào khoảng trống đó: model 1 triệu tham số, chạy trên CPU, không cần PyTorch.
Tôi cài bản 1.1.2 từ PyPI, tự tạo trang test tiếng Việt rồi đo. Kết quả khá hơn tôi kỳ vọng ở tốc độ, và tệ hơn tôi kỳ vọng ở dấu — chi tiết ở dưới, kèm số liệu thật.
Repo: github.com/datalab-to/indra — 1.875 sao, 191 fork, Apache-2.0, tạo 13/10/2026.
Vì sao "chạy trên CPU" là điểm bán hàng thật
Phần lớn công cụ OCR chất lượng cao hiện nay đều gắn với GPU hoặc API đám mây. Với cá nhân thì tốn tiền, với doanh nghiệp thì vướng chuyện dữ liệu ra khỏi máy. Indra chọn hướng ngược: chỉ ONNX Runtime, OpenCV và pypdfium2, tổng model mặc định khoảng 76 MB.
Con số đó nhỏ đến mức đáng ngờ, nên tôi kiểm tra thực tế trên máy mình — Core i7-6700, 4 nhân 8 luồng, không GPU:
- Cài bằng
pip install indra-ocr: xong trong một lệnh, không kéo torch về - Nạp model lần đầu (tải 12 file từ Hugging Face): 10,5 giây
- Trang scan A4 200 DPI, 19 dòng chữ: ~2,1 giây/trang
- 6 trang PDF: 10,3 giây (0,58 trang/giây)
- 8 trang PDF, chạy 8 core: 12,8 giây (0,63 trang/giây)
Lưu ý con số cuối: tăng từ 1 lên 8 core chỉ nhanh hơn khoảng 15%. Tức là nút thắt không nằm ở số nhân mà ở chỗ khác. README ghi "44 trang/giây trên 32 core" — với 4 nhân thực tế thì đừng kỳ vọng gần con số đó.
Tôi cũng phát hiện convert_many trên Windows cần đặt trong if __name__ == "__main__": và phải là file .py thật, không chạy được qua python -c hay stdin — nếu không nó lặng lẽ rơi về chạy một tiến trình và chậm đi đáng kể.
Kiến trúc: bốn bộ nhận dạng, một bộ phân loại
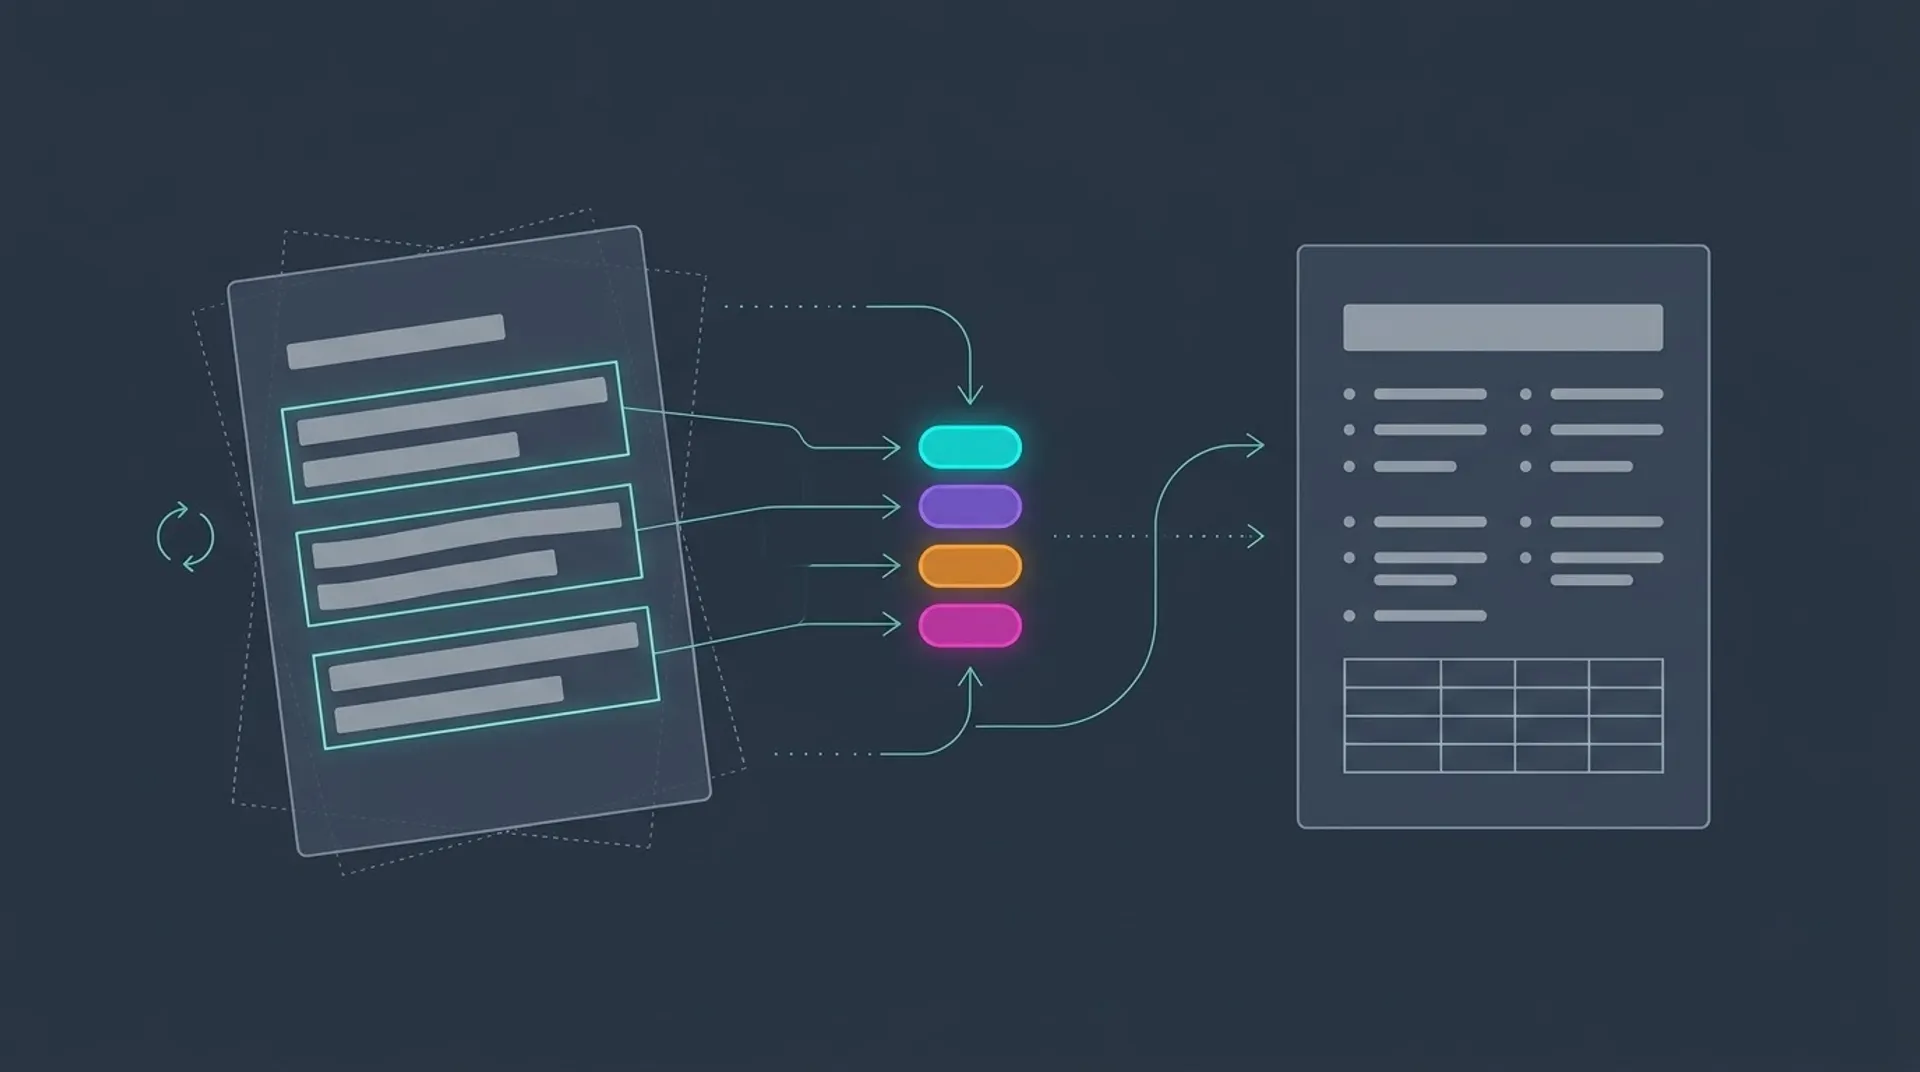
Điểm tôi thấy thông minh nhất trong thiết kế: nó không dùng một model cho tất cả. Có bốn bộ nhận dạng riêng và một bộ phân loại dòng chữ quyết định dòng nào đi vào bộ nào:
rec.onnx— Latin (khoảng 50 ngôn ngữ, có dấu tiếng Việt và Yoruba), Cyrillic, Hy Lạp, và chữ viết tay Latinrec_cjk.onnx— Trung (giản thể và phồn thể), Nhật (kana và kanji), Hànrec_rtl.onnx— Ả Rập, Ba Tư, Urdu, Pashto, Kurd, Hebrew; dòng ra đúng thứ tự logic, trang phải-sang-trái đọc cột phải trướcrec_world.onnx— Devanagari, Bengal, Tamil, Telugu, Kannada, Malayalam, Gujarati, Gurmukhi, Odia, Thái, Lào, Khmer, Myanmar, Sinhala, Georgia, Armenia, Ethiopia
Khi bộ phân loại không chắc, dòng đó được đưa cho bộ nhận dạng chính đọc lại và bản nào tự tin hơn thì thắng. Đây là cách xử lý đúng: thay vì bắt một model gánh 80 ngôn ngữ, chia việc rồi để cơ chế bỏ phiếu quyết định.
Một chi tiết nữa đáng chú ý: với PDF có text layer, nó không OCR. Chế độ mặc định auto đọc text layer ở trang nào vượt qua kiểm tra, chỉ OCR phần thiếu. Tôi đo được: 4 trang PDF số mất 2,65 giây (1,51 trang/giây) — nhanh hơn gần 4 lần so với ép OCR toàn bộ (9,08 giây). Với kho tài liệu số, đây là khác biệt lớn.
Tôi đo tiếng Việt thật — và đây là chỗ đáng nói
README nói rõ: bộ nhận dạng Latin "có dấu thanh của tiếng Việt". Nghe ổn. Nhưng "có hỗ trợ" và "đọc đúng" là hai chuyện khác, nên tôi tự dựng trang test rồi so từng ký tự.
Test 1 — trang in rõ, 200 DPI, 6 trang, 924 từ:
- Độ chính xác theo từ: 97,40% (900/924)
- Độ tương đồng ký tự: 98,84%
Nhìn qua thì tốt. Nhưng đọc danh sách lỗi mới thấy vấn đề: các lỗi không ngẫu nhiên. Chúng rơi vào đúng một nhóm:
thử→thừtiến→tiểndấu→dầucấu→cầu/cẫu
Thấy quy luật chưa? Nó đọc dấu sắc và dấu hỏi thành dấu huyền và dấu ngã. Không phải đoán mò từng chỗ, mà là một thiên lệch có hệ thống: nghiêng về thanh huyền/ngã.
Test 2 — cùng nội dung, hạ xuống 150 DPI (mức scan thưa thật):
Một dòng lặp 45 lần, trong đó có cụm "có dấu". Kết quả:
- Đọc đúng "có dấu": 7/45 dòng
- Đọc thành "có dầu": 38/45 dòng — tức 84% sai
Ở độ phân giải thấp, lỗi dấu không còn lẻ tẻ mà thành mặc định. Con số này quan trọng vì tài liệu thật thường scan ở 150–200 DPI, không phải 300.
Kết luận thực dụng cho người dùng Việt: Indra đọc tốt để tìm kiếm và hiểu nội dung, nhưng không dùng để xuất bản hoặc lưu trữ pháp lý mà chưa qua người soát. Lỗi dấu làm đổi nghĩa từ, và với hợp đồng thì đó là rủi ro thật.
Những gì nó làm tốt
Để công bằng, có mấy điểm tôi kiểm tra và thấy đúng như quảng cáo:
- Xử lý trang nghiêng và lộn ngược. Có model orientation riêng, tự xoay 90/180/270 độ và nắn nghiêng nhỏ. Trường
rotationvàskewtrả về cho biết nó đã làm gì - Chữ Trung/Nhật dọc. Trang dọc được đọc xoay một phần tư vòng để mỗi cột thành một dòng cho bộ CJK — chi tiết này nhiều công cụ bỏ qua
- Bố cục có nhãn. Mỗi khối trả về nhãn:
Text,Section-Header,Page-Header,List-Group,Table,Caption,Footnote,Table-Of-Contents,Form— kèm thứ tự đọc - Bỏ header/footer mặc định. Muốn giữ thì thêm
--keep-furniture - Không có PyTorch. Cài đặt gọn, không kéo cả một framework nặng về máy
Những gì nó làm chưa tốt (theo chính README)
Điểm tôi thích ở repo này: phần Limitations viết thẳng, không giấu.
- Bảng phức tạp. Ô gộp, ô trải nhiều dòng, header lồng nhau, bảng không có đường kẻ — dễ ra sai hàng sai cột. Bảng lưới đơn giản thì tốt
- Chữ viết tay. Chỉ 25,2% trên bộ test viết tay, khoảng một phần ba số từ trên trang thật. Chữ thảo và bút chì mờ tệ nhất
- Scan cũ, mờ, độ phân giải thấp. 29,5% trên bộ test scan xuống cấp
- Ngôn ngữ Latin nhiều dấu. README tự nhận: với Kurmanji, Séc, Litva, Iceland, Thổ, Slovak, model hay ghi dấu gần giống thay vì dấu đúng. Tiếng Việt không nằm trong danh sách này — nhưng như tôi vừa đo, nó vẫn có vấn đề riêng
- Trang quá rộng dạng banner đọc kém; nhãn trong bản vẽ kỹ thuật hay ra thành mẩu vụn
Cách dùng thực tế
Cài và chạy cơ bản:
pip install indra-ocr

indra-ocr paper.pdf                    # markdown ra stdout
indra-ocr *.pdf --out results/         # mỗi file một .md, dùng toàn bộ core
indra-ocr scan.png --format json       # dòng, khung, khối bố cục, độ tin cậy
indra-ocr paper.pdf --keep-furniture   # giữ cả header/footer
Dùng từ Python khi cần xử lý tiếp:
import indra_ocr

conv = indra_ocr.load(threads=4)
for i, page in conv.convert("paper.pdf"):
    print(page.source)        # text | ocr | hybrid | error
    print(page.markdown)      # tiêu đề, danh sách, bảng dạng HTML
    page.blocks               # [{"label", "bbox", "text"}] theo thứ tự đọc
    page.lines                # Line(box, text, conf)
Muốn xem trực quan thì có viewer cục bộ, mở ở cổng 8765, kéo thả file vào là thấy từng dòng, từng khối, thứ tự đọc và thời gian từng bước. File không rời khỏi máy:
indra-ocr-viewer --port 8765Một mẹo nhỏ tôi rút ra khi test: nếu tài liệu quan trọng, hãy render PDF ở 300 DPI trước khi đưa vào. Ở 150 DPI tỉ lệ lỗi dấu tăng vọt, còn 200 DPI là mức chấp nhận được cho văn bản hành chính thông thường.
Giấy phép: đọc kỹ trước khi dùng thương mại
Đây là chỗ dễ hiểu nhầm nhất. Code là Apache-2.0, nhưng trọng số model dùng giấy phép OpenRAIL-M sửa đổi: miễn phí cho nghiên cứu, dùng cá nhân, và startup dưới 20 triệu USD vốn hoặc doanh thu. Có một điều khoản cấm dùng để cạnh tranh trực tiếp với API của họ.
Nghĩa là: cài về xài cá nhân thì thoải mái. Đưa vào sản phẩm thương mại quy mô lớn thì phải xem lại điều khoản, hoặc mua giấy phép. Đừng đọc mỗi chữ Apache-2.0 ở badge rồi tưởng là thoáng hoàn toàn.
Nên và không nên dùng
Nên khi bạn cần số hoá kho tài liệu mà không muốn gửi dữ liệu lên đám mây, khi máy không có GPU, khi cần chạy trong CI hoặc container nhẹ, hoặc khi cần bóc bố cục chứ không chỉ lấy chữ trơn.
Không nên khi bạn cần đọc bảng phức tạp chính xác cao, khi tài liệu là chữ viết tay, khi scan quá cũ mờ, hoặc khi đầu ra tiếng Việt phải đúng dấu tuyệt đối mà không có người soát. Với ba trường hợp đó, trả tiền cho một dịch vụ có model lớn hơn vẫn rẻ hơn là sửa lỗi bằng tay.
Và một lưu ý cuối: nếu nhu cầu của bạn là đọc tài liệu tiếng Việt để hiểu — tóm tắt, tìm kiếm, phân loại — thì 97,4% độ chính xác từ là quá đủ. Nếu là để trích dẫn nguyên văn, hãy coi đầu ra là bản nháp cần soát, không phải bản cuối.
Kết luận
Indra OCR là một trong số ít repo AI mới mà tôi thấy đáng cài thử ngay: cài một lệnh, không GPU, không PyTorch, chạy được trong 10 giây sau khi tải model. Triết lý chia bốn bộ nhận dạng theo hệ chữ thay vì nhồi một model là thiết kế đúng, và việc ưu tiên đọc text layer của PDF số là chi tiết thực dụng mà nhiều công cụ bỏ sót.
Điểm trừ của nó với tiếng Việt là thật và có hệ thống — không phải lỗi vặt. Nhưng biết rõ mình đang ở đâu thì vẫn dùng được: nó là công cụ số hoá và tìm kiếm rất tốt, chỉ không phải công cụ xuất bản.
Repo: github.com/datalab-to/indra — Apache-2.0 cho code, OpenRAIL-M cho trọng số.