
Paperless-ngx: số hoá giấy tờ, tìm được chữ trong bản scan
 Quản trị viên
Paperless-ngx 48.365 sao: ném PDF vào là tự OCR, tự đặt tên, tự gắn tag. Tìm được chữ bên trong bản scan. Giấy tờ không rời khỏi máy.
Paperless-ngx biến đống giấy tờ scan thành kho tài liệu tìm kiếm được. Bạn ném PDF vào một thư mục, nó tự đọc chữ trong ảnh, đoán loại giấy tờ, gắn tag, đặt tên file theo ngày và người gửi — rồi lưu tất cả vào một chỗ.
Tôi không cài (bài dùng ảnh chụp chính thức trong repo), nhưng số liệu dưới đây đọc từ GitHub API ngày 20/11/2026.
Bảng số đo
| Thông số | Giá trị |
|---|---|
| Sao / fork | 48.365 / 3.414 |
| Commit 90 ngày gần nhất | 637 |
| Commit 52 tuần | 1.830 |
| Bản phát hành 12 tháng | 40 |
| Ngôn ngữ chính | Python |
| Issue đang mở | 10 — thấp nhất trong loạt bài |
| Kích thước repo | 233,1 MB |
| Giấy phép | GPL-3.0 |
Hai con số đáng chú ý. 637 commit trong 90 ngày (7,1 commit/ngày) nhưng chỉ 10 issue mở — nghĩa là đội ngũ xử lý gần như sạch hàng đợi. Trong loạt bài này, đây là tỷ lệ ấn tượng nhất: các dự án khác để tồn 400–3.500 issue.
Giao diện: chế độ tối, lưới tài liệu có tag màu
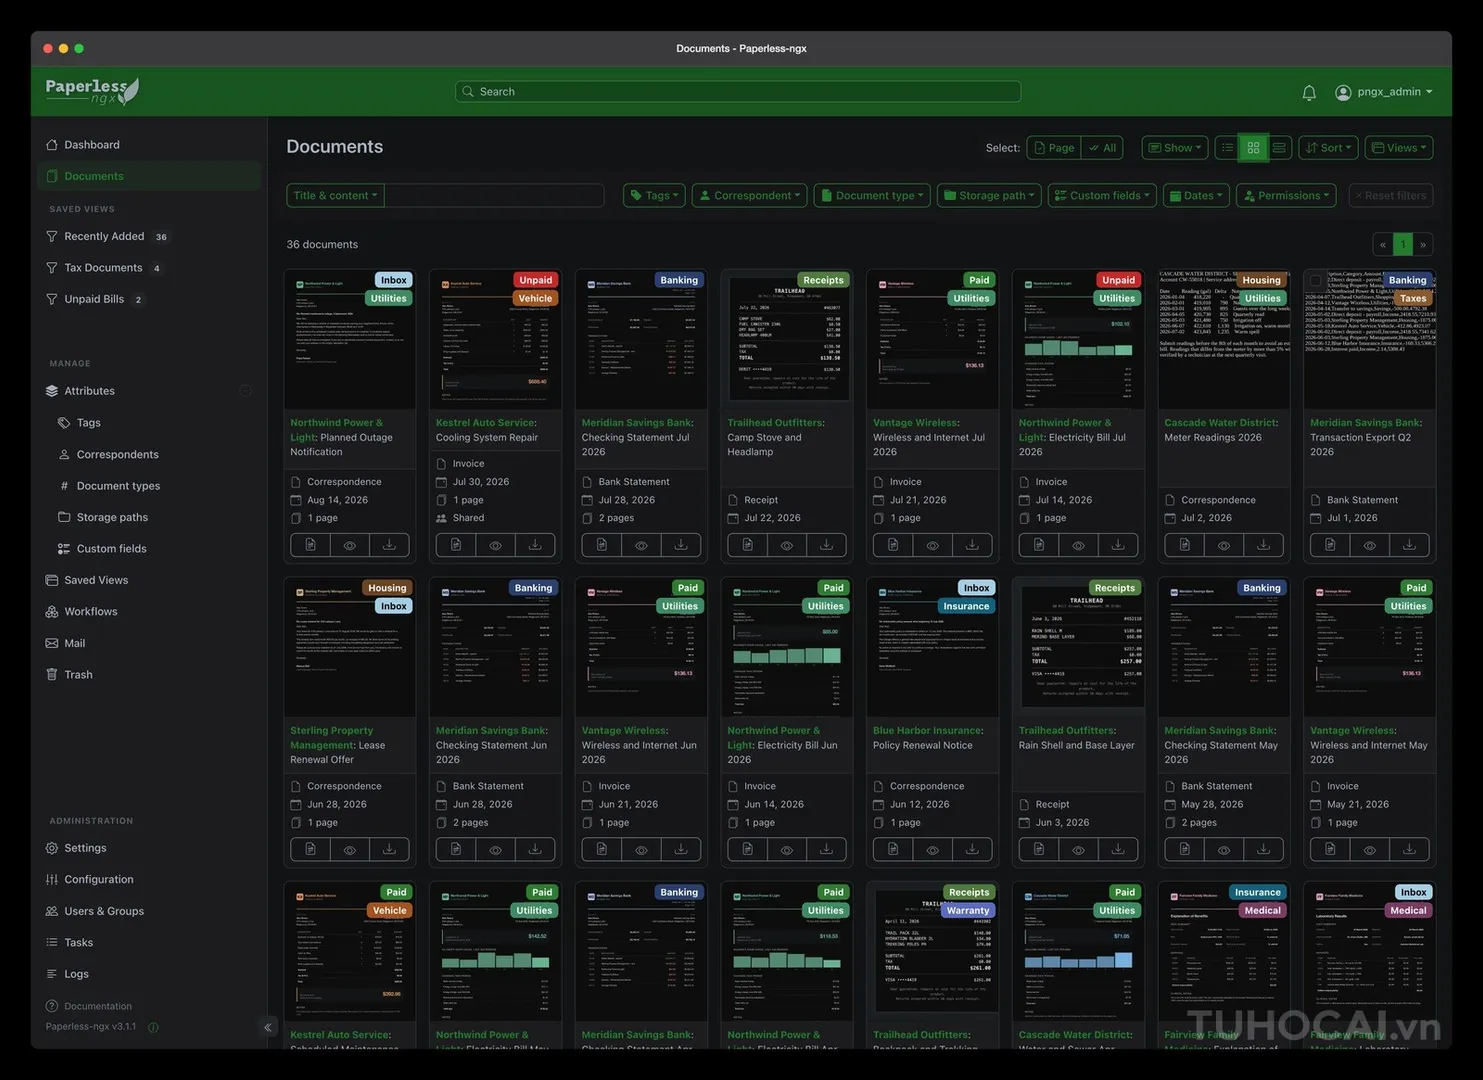
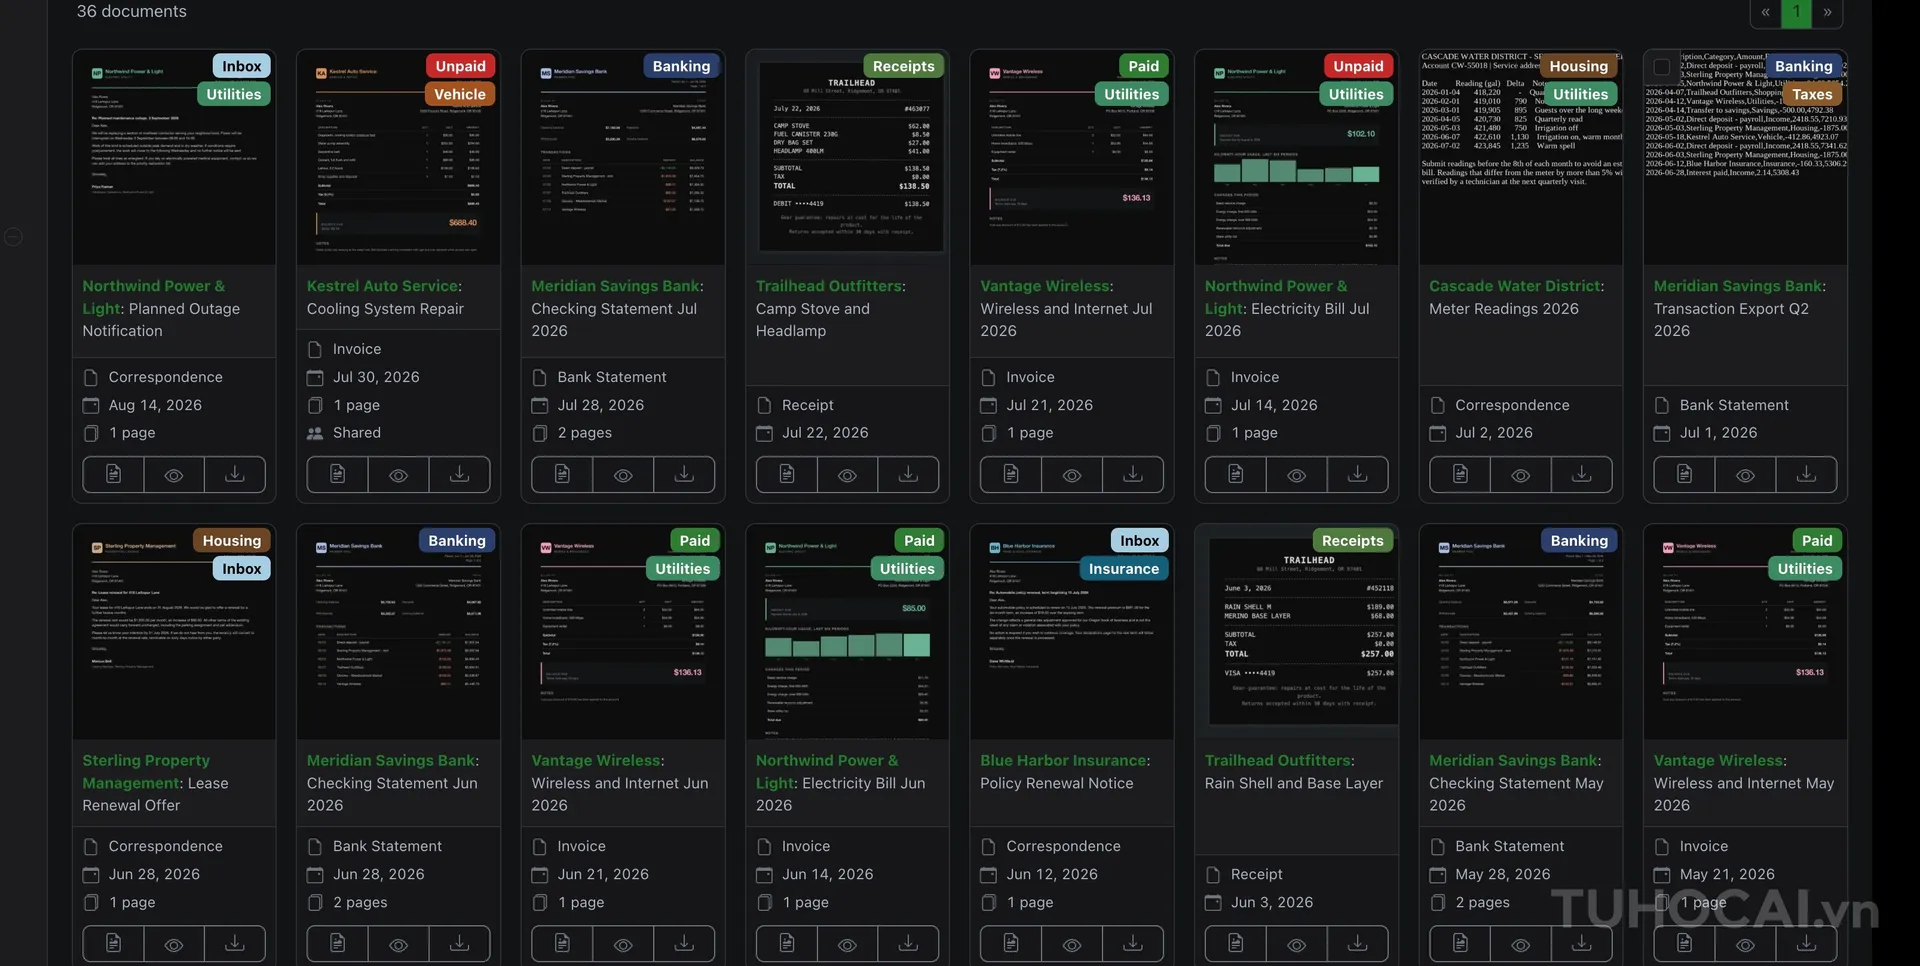
Ảnh dưới là màn hình tài liệu thật, với 36 văn bản mẫu đã được xử lý.
Cấu trúc quen thuộc với người dùng hệ quản lý tài liệu, nhưng cách trình bày rất "đọc được":
- Thẻ tài liệu hiện ảnh thu nhỏ của trang đầu — nhìn là nhận ra hoá đơn hay hợp đồng, không cần đọc tên file.
- Tag màu nằm góc trên phải mỗi thẻ: Inbox, Utilities, Unpaid, Vehicle, Banking, Receipts, Paid, Housing, Taxes, Insurance, Warranty, Medical.
- Tên tài liệu do máy tự đặt theo mẫu, ví dụ "Northwind Power & Light: Planned Outage Notification".
- Dòng metadata bên dưới: người gửi, ngày, số trang.
Cột trái có mục Saved Views với số đếm thật: Recently Added (36), Tax Documents (4), Unpaid Bills (2). Đây là cách dùng thực tế nhất — không phải mở thư mục, mà mở một khung nhìn đã lọc sẵn.
Điều làm nó khác Google Drive
Google Drive lưu file. Paperless-ngx hiểu nội dung file. Cụ thể:
| Việc | Google Drive | Paperless-ngx |
|---|---|---|
| Tìm theo chữ trong ảnh scan | Chỉ với file đã có lớp text | Tự OCR mọi file đưa vào |
| Đặt tên file | Bạn tự đặt | Tự đặt theo mẫu cấu hình được |
| Gắn tag | Thủ công | Tự gắn theo từ khoá, người gửi, loại giấy |
| Tìm "hoá đơn điện chưa trả" | Gõ từ khoá, tự lọc | Lưu thành Saved View, mở là ra |
| Dữ liệu ở đâu | Máy chủ Google | Máy của bạn |
Điểm mấu chốt là quy trình tự động: bạn không tổ chức file, bạn cấu hình luật một lần rồi ném file vào. Với người có vài trăm hoá đơn mỗi năm, đây là khác biệt lớn về thời gian.
Cài bằng Docker: ba thành phần
# 1. tai file cau hinh chuan
mkdir paperless && cd paperless
wget https://raw.githubusercontent.com/paperless-ngx/paperless-ngx/main/docker/compose/docker-compose.postgres.yml
wget https://raw.githubusercontent.com/paperless-ngx/paperless-ngx/main/docker/compose/.env

# 2. sua .env: dat USERMAP_UID/GID va duong dan luu
# 3. chay
docker compose -f docker-compose.postgres.yml up -d

# 4. mo http://localhost:8000
Ba thành phần: web server (giao diện + API), worker (OCR và phân loại), database PostgreSQL. Bản mặc định dùng SQLite nhưng khuyến nghị Postgres nếu chạy thật — SQLite khoá file khi worker đang OCR.
OCR tiếng Việt cần cấu hình thêm: đặt biến PAPERLESS_OCR_LANGUAGE=vie trong .env. Mặc định là tiếng Anh; không đổi thì giấy tờ tiếng Việt sẽ ra chữ rác.
Giấy phép GPL-3.0 — ràng buộc cần biết
GPL-3.0 là giấy phép có tính lan truyền: nếu bạn sửa Paperless-ngx và phân phối bản đã sửa, bạn phải công khai mã nguồn.
- Dùng cho gia đình và công ty nội bộ: không ảnh hưởng gì.
- Sửa để dùng riêng: không phải công khai (không phân phối).
- Bán bản đã sửa hoặc cung cấp như dịch vụ: phải mở mã nguồn.
Ba điểm yếu thật
1. OCR vẫn cần kiểm tay với bản scan xấu. Hoá đơn chụp nghiêng, mờ, hoặc in chữ nhỏ sẽ ra kết quả sai vài chỗ. Paperless lưu cả ảnh gốc và lớp text, nên tra cứu được, nhưng đừng tin tuyệt đối vào phần chữ máy đọc.
2. Không phải hệ thống lưu trữ tuân thủ pháp lý. Không có chữ ký số, không có dấu thời gian được chứng thực, không có cơ chế chống sửa đổi. Với giấy tờ cần giá trị pháp lý, đây không thay thế được hệ thống lưu trữ chuyên dụng.
3. Tiêu tốn tài nguyên khi nhập lô lớn. Worker OCR chạy hết CPU khi xử lý hàng nghìn file. Trên máy yếu, việc nhập 5.000 tài liệu lần đầu có thể mất vài ngày và làm máy chậm suốt thời gian đó.
Ai nên dùng
Rất phù hợp nếu:
- Bạn có hàng trăm hoá đơn, hợp đồng, giấy tờ cần tra cứu thường xuyên.
- Bạn muốn tìm theo nội dung bên trong file scan, không chỉ theo tên file.
- Giấy tờ không được phép tải lên dịch vụ cloud nước ngoài.
- Bạn đã có NAS hoặc server chạy 24/7.
Không phù hợp nếu:
- Bạn chỉ có vài chục file — tạo thư mục trên Drive nhanh hơn nhiều.
- Bạn cần lưu trữ có giá trị pháp lý, chống sửa đổi.
- Máy không đủ CPU cho OCR và bạn cần nhập lô lớn.
- Bạn không muốn vận hành Docker + database + worker.
Cách tôi kiểm số liệu
Số sao, fork, issue, kích thước repo, commit 90 ngày và 52 tuần, số bản phát hành 12 tháng đọc từ api.github.com. Giấy phép xác nhận qua trường license của API là GPL-3.0. Các con số hiển thị trong ảnh (36 tài liệu, 4 tax documents, 2 unpaid bills) là dữ liệu mẫu của chính dự án, không phải số tôi đo — bài ghi rõ để tránh nhầm.
Những gì tôi chưa kiểm: chất lượng OCR tiếng Việt thật trên hoá đơn Việt Nam, thời gian xử lý 1.000 file, và mức RAM của worker. Ba việc đó cần chạy thật với dữ liệu thật.
Nguồn tham khảo
- paperless-ngx/paperless-ngx (GitHub) — 48.365 sao, GPL-3.0, chỉ 10 issue mở
- Paperless-ngx — tài liệu chính thức — Cài đặt, cấu hình OCR, luật tự động
- Paperless-ngx — bản phát hành — v3.5.1, 40 bản trong 12 tháng
- Tesseract — gói ngôn ngữ — Gói vie.traineddata cho OCR tiếng Việt